Vergleich zweier Messmethoden: Bland-Altman-Analysen

Vergleich zweier Messmethoden: Bland-Altman-Analysen

Vergleich zweier Messmethoden: Bland-Altman-Analysen

In der klinischen Forschung ist es häufig wichtig, den Grad der Übereinstimmung zwischen zwei Messmethoden (die den gleichen Parameter messen sollen) zu ermitteln, zum Beispiel um zu entscheiden, ob man eine Messmethode durch eine andere ersetzen kann oder zur Evaluation einer neuen, alternativen Messmethode.

Die richtige Methode zur Ermittlung und Bewertung der Übereinstimmung ist allerdings oft nicht direkt ersichtlich und häufig wird dafür eine Korrelations- oder Regressionsanalyse herangezogen. Warum das nicht der optimale Weg ist und was du stattdessen tun solltest erklären wir dir in diesem kurzen Artikel.

Ein einfaches Beispiel


Angenommen, du möchtest die Übereinstimmung zwischen zwei Messmethoden zur Messung des Blutzuckers ermitteln und hast dafür bei n = 100 Patienten, jeweils mit beiden Methoden, den Blutzucker gemessen.

Du hast also insgesamt 100 Datenpaare, nämlich für jeden Patienten eine Messung mit Methode 1 und eine Messung mit Methode 2.

Korrelation und Regression


Der einfachste Weg der Darstellung der so erhobenen Daten ist eine Punktwolke, in der für jeden Patienten der Wert von Methode 1 gegen den Wert von Methode 2 abgetragen ist.

Zusätzlich kann man die Korrelation zwischen beiden Methoden bestimmen und die zugehörige Regressionsgerade in die Punktwolke einzeichnen. Wie du sicher schon weißt erfasst die Korrelation den linearen Zusammenhang zwischen zwei Variablen und liegt stets zwischen -1 und +1, wobei -1 für einen perfekten negativen und +1 für einen perfekten positiven linearen Zusammenhang steht.

Falls du vorher noch nie etwas von der Korrelation gehört haben solltest oder deine Kenntnisse kurz auffrischen möchtest, schau doch einfach mal in unseren Blog-Artikel zu diesem Thema .

Die folgende Graphik zeigt die Punktwolke für unser (fiktives) Beispiel mit Regressionsgerade und Korrelationskoeffizient r. 

Balkendiagramm Chi Quadrat Test Medizin

Wie du sehen kannst, liegt eine nahezu perfekte positive Korrelation vor (r > 0.99), was sich graphisch auch dadurch ablesen lässt, dass sämtliche Datenpunkte nur minimal von der Regressionsgerade abweichen (bei einer perfekten Korrelation würden sämtliche Punkte auf der Geraden liegen).


Ist das nun ein Beleg dafür, dass beide Methoden zur Messung des Blutzuckers übereinstimmen? Oder anders: Ist es letztendlich egal, ob du Methode 1 oder Methode 2 zur Messung verwendest, da beide zu dem (annähernd) gleichen Ergebnis führen? Um diese Fragen zu beantworten wollen wir nun einen anderen Blick auf unsere Daten werfen.

Die Analyse von Unterschieden: Die Bland-Altman-Methode


Die grundsätzliche Idee der Bland-Altman-Methode ist, zur Beurteilung der Übereinstimmung zwischen zwei Messmethoden statt der Korrelation der Messwerte die Differenzen zwischen beiden Methoden zu analysieren. In unserem Beispiel heißt das also, dass wir für jeden der 100 untersuchten Patienten den Unterschied in der Blutzuckermessung zwischen Methode 1 und Methode 2 (Wert aus Methode 1 minus Wert aus Methode 2) bestimmen.


Wenn beide Methoden wirklich exakt gleich messen würden, dann sollten diese Differenzen alle 0 betragen. Der Mittelwert dieser Abweichungen lässt sich dann dazu nutzen, um die Unterschiedlichkeit beider Methoden in einem Maß auszudrücken.


Im Kontext von Bland-Altman-Analysen wird dieser Mittelwert auch der Bias genannt. Ist der Bias größer als 0, dann fallen die mit Methode 1 erhobenen Werte im Schnitt größer aus als die mit Methode 2 erhobenen. Ist der Bias kleiner als 0, dann fallen die mit Methode 1 erhobenen Werte im Schnitt kleiner aus. Für diesen Bias lassen sich dann auch Konfidenzintervalle berechnen und ein Signifikanztest durchführen, der testet, ob der Bias auf Populationsebene signifikant verschieden von 0 ist.      


Außerdem werden im Rahmen von Bland-Altman-Analysen die sogenannten limits of agreement (Übereinstimmungsgrenzen) zwischen beiden Methoden berechnet. Diese sind gegeben durch den ermittelten Bias ± 1.96 mal der Standardabweichung der Differenzen zwischen beiden Methoden. Du kannst dir die Übereinstimmungsgrenzen so vorstellen, dass sich (auf Populationsebene) 95% aller Differenzen zwischen Methode 1 und Methode 2 innerhalb dieser Grenzen befinden.


Während sich anhand des Bias also ablesen lässt, wie groß die systematische Abweichung zwischen beiden Methoden ausfällt, gibt die Breite der limits of agreement also an, wie stark die Differenzen um diesen Bias streuen. Beide Größen solltest du zur Beurteilung der Übereinstimmung zwischen beiden Methoden heranziehen. Statistische Voraussetzung für den Signifikanztest und eine sinnvolle Berechnung der Übereinstimmungsgrenzen ist (wie so häufig), dass die Differenzen zwischen beiden Methoden aus einer Normalverteilung stammen.

Bland-Altman-Plots


Die Ergebnisse von Bland-Altman-Analysen werden üblicherweise in einer Graphik, dem Bland-Altman-Plot, zusammengefasst. Für jeden Patienten bzw. jede Messung ist auf der y-Achse die Differenz zwischen den beiden Methoden abgetragen und auf der x-Achse der Mittelwert der beiden Messungen. Außerdem sind der Bias sowie die Übereinstimmungsgrenzen abgetragen, meist mit dem jeweils zugehörigem 95%-Konfidenzintervall. 

Die folgende Graphik zeigt den Bland-Altman-Plot für unser Beispiel.

Balkendiagramm Chi Quadrat Test Medizin

Du kannst hier sofort sehen, welchen Vorteil die Bland-Altman-Methode im Vergleich zur Korrelations- oder Regressionsanalyse bietet. Der Bias in unserem Beispiel beträgt 1.22, was also bedeutet, dass die mit Methode 1 gemessenen Werte im Durchschnitt um 1.22 Einheiten größer ausfallen als die mit Methode 2 gemessenen. Dieser Bias ist signifikant (p < .05) verschieden von 0, was sich in der Graphik daran ablesen lässt, dass das 95%-Konfidenzintervall des Bias die von der 0 ausgehende durchgezogene Linie nicht enthält. Das untere Übereinstimmungsgrenze liegt bei etwa -0.45 und die obere bei etwa 2.89.

Interpretation


Die Bland-Altman-Methode zeigt für unser Beispiel also eine systematische Abweichung zwischen den beiden Methoden zur Messung des Blutzuckers, die sich in keiner Weise anhand der (fast perfekten) Korrelation bzw. der Punktwolke mit Regressionsgerade ablesen lässt. Außerdem lässt sich über die beiden Übereinstimmungsgrenzen feststellen, dass sich der Großteil der Abweichungen der Messwerte zwischen beiden Methoden in einem Intervall von etwa 2.3 Einheiten bewegt. Soweit die rein statistische Seite.


Ob diese über die Bland-Altman-Methode ermittelten Größen in der Praxis für eine „gute“ oder „schlechte“ Übereinstimmung zwischen beiden Methoden sprechen und welche praktischen Konsequenzen daraus gezogen werden sollten sind allerdings Fragen, die sich allein über zusätzliche biologische oder klinisch-inhaltliche Überlegungen beantworten lassen. Klar: Wenn der Bias und das durch die limits of agreement gegebene „Übereinstimmungsintervall“ beide 0 wären, dann läge eine perfekte Übereinstimmung zwischen beiden Methoden vor. Aber das wird in der Praxis wohl nie vorkommen. Aber ab wann der Bias bzw. das Übereinstimmungsintervall „zu groß“ bzw. eben die Übereinstimmung „zu gering“ ist, ist keine statistische Frage, sondern eine klinisch-inhaltliche, die eben auch nach klinisch-inhaltlichen Kriterien bewertet werden muss. Idealerweise legst du daher schon vor deiner Untersuchung fest, wie groß der Bias und das Übereinstimmungsintervall maximal sein sollten, um noch akzeptabel zu sein.

Worauf du noch achten solltest: Systematische Trends in den Abweichungen


Wie so oft in der Statistik ist es auch bei Bland-Altman-Analysen enorm wichtig, die relevanten Parameter wie etwa den Bias nicht bloß zu berechnen, sondern sich die Daten auch graphisch anhand des Bland-Altman-Plots zu veranschaulichen. Ansonsten kann es passieren, dass dir relevante Aspekte deiner Analysen verlorengehen. Beispielsweise kann es sein, dass systematische Trends in den Abweichungen zwischen Methode 1 und Methode 2 vorliegen, obwohl insgesamt kein Bias vorliegt. Was ist damit gemeint? Schauen wir uns ein neues Beispiel und zunächst wieder die zugehörige Punktwolke mit Regressionsgerade an.

Balkendiagramm Chi Quadrat Test Medizin

Auch hier liegt wieder eine fast perfekte Korrelation (r > 0.99) zwischen den mit Methode 1 und den mit Methode 2 gemessenen Blutzuckerwerten vor. Wie sieht für dieses Beispiel der Bland-Altman-Plot aus?

Balkendiagramm Chi Quadrat Test Medizin

Wie du sehen kannst liegt hier kein Bias vor. Was aber auffällt ist, dass bei (mittleren) Messwerten bis etwa 100 die Differenzen tendenziell positiv sind (also Methode 1 größere Werte liefert als Methode 2), bei Messwerten über 100 jedoch die Differenzen tendenziell negativ sind (also Methode 1 kleinere Werte liefert als Methode 2). Was bedeutet das inhaltlich?


Wenn man über den gesamten Messbereich hinweg den Mittelwert der Differenzen zwischen beiden Methoden betrachtet, dann ist dieser zwar insgesamt Null, es liegt aber ein sogenannter proportional bias vor, den du auf jeden Fall ebenfalls zur Beurteilung der Übereinstimmung der beiden Methoden heranziehen solltest. Im „unteren Wertebereich“ bringt Methode 1 systematisch größere Werte als Methode 2 und im „oberen Wertebereich“ verhält es sich genau umgekehrt. Dieser in diesem Beispiel vorliegende proportional bias wird deutlicher, wenn man die zu den Abweichungen zugehörige Regressionsgerade zusätzlich in den Bland-Altman-Plot einzeichnet.

Balkendiagramm Chi Quadrat Test Medizin

Es kann also auch eine variable Übereinstimmung zwischen beiden Methoden in Abhängigkeit des Wertebereichs vorliegen, was aber nur durch eine graphische Analyse mittels des Bland-Altman-Plots erkennbar wird.

Zusammenfassung

Möchtest du die Übereinstimmung zwischen zwei Messmethoden evaluieren, dann kann eine Korrelations- oder Regressionsanalyse ungeeignet und irreführend sein. Die Bland-Altman-Methode der Analyse von Unterschieden bzw. der zugehörige Bland-Altman-Plot ist ein einfaches und intuitiv nachvollziehbares Verfahren, um systematische Abweichungen zwischen beiden Methoden festzustellen und zu quantifizieren.


Du solltest dabei folgendermaßen vorgehen:

    1. Berechne die Differenzen und den Mittelwert pro Messung.
    2. Überprüfe, ob diese Differenzen normalverteilt sind (graphische Analyse und/oder statistischer Test).
    3. Berechne den Bias und die Übereinstimmungsgrenzen (limits of agreement).
    4. Erstelle den Bland-Altman-Plot.
    5. Überprüfe anhand des Plots, ob ggf. ein systematischer Trend (proportional bias) in den Abweichungen vorliegt.
    6. Interpretation der Ergebnisse anhand biologischer und/oder klinisch-inhaltlicher Kriterien.

    Die Schritte (1) bis (4) musst du natürlich nicht „per Hand“ machen, das lässt sich ganz komfortabel in R durchführen. Wie so oft in der Statistik ist der letzte Schritt, also die inhaltliche Interpretation, am wichtigsten und häufig auch am schwierigsten.


    Ob der Bias und die Übereinstimmungsgrenzen aus klinischer Sicht noch akzeptabel sind oder nicht, darüber gibt die Bland-Altman-Methode keine Auskunft. Idealerweise hast du bereits vor den Analysen anhand inhaltlicher Kriterien festgelegt, wie groß Bias und Übereinstimmungsgrenzen für deine Zwecke maximal sein dürfen.

    Der Chi-Quadrat-Test: Zusammenhänge zwischen kategorialen Variablen analysieren

    Der Chi-Quadrat-Test: Zusammenhänge zwischen kategorialen Variablen analysieren

    Der Chi-Quadrat-Test: Zusammenhänge zwischen kategorialen Variablen analysieren

    In der medizinischen Statistik geht es häufig um Fragestellungen wie „Tritt Krankheit X bei Frauen häufiger auf als bei Männern?“ oder „Wird Therapie Y bei älteren Menschen häufiger verwendet als bei jüngeren?“. Oder es soll herausgefunden werden, ob sich die zwei oder mehr Gruppen einer Untersuchung hinsichtlich eines bestimmten kategorialen Merkmals (Geschlecht, Bildungsgrad, ASA-Klassifikation…) unterscheiden.

    Fragestellungen dieser Art sind ein klarer Fall für den χ2-Test (ausgesprochen: „Chi-Quadrat“) und hier erläutern wir dir ganz kurz anhand eines simplen Beispiels, was die Grundidee dieses Tests ist und wie du das Testergebnis richtig interpretierst.

    Ein simples (und fiktives) Beispiel


    Angenommen du möchtest herausfinden, ob die Wirksamkeit eines bestimmten Medikaments bei Männern und Frauen unterschiedlich ist. Dafür hast du in deiner Untersuchung bei insgesamt 200 Patient:innen folgende beiden Merkmale erhoben:


    1. das Geschlecht (der Einfachheit halber „weiblich“ oder „männlich“)
    2. die Wirksamkeit des Medikaments (der Einfachheit halber „wirksam“ oder „nicht wirksam“)


    Um ein klein wenig „Statistiksprech“ in das Beispiel zu bringen: Du hast also zwei kategoriale Variablen (auch nominale Variablen genannt) mit jeweils zwei Ausprägungen (weiblich/männlich bzw. wirksam/nicht wirksam) und möchtest nun analysieren, ob zwischen diesen Variablen ein Zusammenhang besteht oder ob diese unabhängig voneinander sind.

    Zusammenhang und Unabhängigkeit


    Was bedeutet Zusammenhang bzw. Unabhängigkeit hier inhaltlich? Wenn die beiden Variablen Geschlecht und Wirksamkeit unabhängig voneinander wären, dann würde das bedeuten, dass es für die Wirksamkeit des Medikaments keine Rolle spielt, ob die Person, die es bekommt, männlich oder weiblich ist – die Wahrscheinlichkeit, dass das Medikament wirkt, wäre für alle gleich. 


    Wenn hingegen ein Zusammenhang besteht, dann wäre die Wirksamkeit des Medikaments vom Geschlecht abhängig. Das würde bedeuten, dass das Medikament entweder bei den Frauen wirksamer ist oder eben bei den Männern.


    Für eine solche Art Fragestellung verwendest du den Chi-Quadrat-Test, genauer gesagt den Chi-Quadrat-Test auf Unabhängigkeit, da es unterschiedliche Chi-Quadrat-Tests für ganz unterschiedliche Analysezwecke gibt.

    Häufigkeitstabellen


    Ein unverzichtbares Werkzeug bei der statistischen Analyse solcher Fragestellungen sind sogenannte Häufigkeitstabellen, oft auch Kreuztabellen genannt.


    In einer absoluten Häufigkeitstabelle wird einfach angegeben, wie oft die verschiedenen Ausprägungen deiner beiden Variablen in deinen Daten aufgetreten sind – in unserem Beispiel also, wie oft bei den Männern das Medikament wirksam war und wie oft nicht — und das Gleiche natürlich auch bei den Frauen. Die absolute Häufigkeitstabelle könnte etwa folgendermaßen aussehen:


      Männer Frauen Σ
    wirksam 43 82 125
    nicht wirksam 39 36 75
    Σ 82 118 200


      Männer Frauen Σ
    wirksam 43 82 125
    nicht wirksam 39 36 75
    Σ 82 118 200


    Von den 200 Patient:innen waren also 82 Männer und 118 Frauen. Bei 43 der 82 Männer war das Medikament wirksam, bei 39 nicht. Bei den Frauen zeigte das Medikament in 82 von 118 Fällen eine Wirksamkeit und in 36 von 118 Fällen war es nicht wirksam. Insgesamt war das Medikament also bei 125 Patient:innen wirksam und bei 75 nicht.


    Oft ist es allerdings inhaltlich sinnvoller, statt der absoluten Häufigkeitstabelle die bedingte relative Häufigkeitstabelle zu verwenden, vor allem, wenn deine beiden Gruppen (hier Männer und Frauen) unterschiedlich groß sind. Für unsere Fragestellung etwa lohnt es sich anzuschauen, bei wie viel Prozent der Männer und wie viel Prozent der Frauen das Medikament wirksam bzw. nicht wirksam war. So kannst du die beiden Gruppen viel besser miteinander vergleichen und bekommst ein klareres Bild über mögliche Unterschiede. 


    Den Prozentsatz der Frauen, bei denen das Medikament wirksam war, berechnest du ganz einfach: Du teilst die absolute Häufigkeit der Frauen, bei denen das Medikament wirksam war (82) durch die Gesamtanzahl der Frauen (118) und multiplizierst das Ergebnis mit 100. Den Rest der Tabelle bekommst du auf analoge Weise. Klar: Wenn du die Werte für die Männer bzw. für die Frauen spaltenweise addierst muss natürlich 100% rauskommen.


    Für unser Beispiel sieht die nach den beiden Geschlechtern bedingte relative Häufigkeitstabelle folgendermaßen aus:


      Männer Frauen
    wirksam 52,44 % 69,49 %
    nicht wirksam 47,56 % 30,51 %
    Σ 100,0 % 100,0 %


      Männer Frauen
    wirksam 52,44 % 69,49 %
    nicht wirksam 47,56 % 30,51 %
    Σ 100,0 % 100,0 %


    Anhand dieser Tabelle kannst du sofort (deskriptiv!) ablesen, dass der Prozentsatz der Frauen, bei denen das Medikament wirksam war, höher ist als der entsprechende Prozentsatz bei den Männern (69.49 % vs. 52.44 %). 

    Graphische Darstellung als Balkendiagramm


    Eine einfache Möglichkeit, diesen Unterschied auch graphisch darzustellen, ist das Balkendiagramm. Dabei werden die entsprechenden Häufigkeiten (du kannst mit einem Balkendiagramm sowohl die absoluten als auch die bedingten Häufigkeiten darstellen) durch die Höhe entsprechender Balken repräsentiert.


    Ein Balkendiagramm für unsere bedingte relative Häufigkeitstabelle würde dann folgendermaßen aussehen:   

    Balkendiagramm Chi Quadrat Test Medizin

    Der Chi Quadrat-Test


    Dass das Medikament in deiner Stichprobe bei den Frauen deskriptiv häufiger wirksamer war als bei den Männern bedeutet für sich genommen natürlich noch nicht, dass es auch auf der Populationsebene („allgemein“) bei Frauen wirksamer ist als bei Männern. Um das herauszufinden müssen wir einen inferenzstatistischen Test (nämlich den besagten Chi-Quadrat-Test) durchführen!


    Falls dir der für die Statistik fundamentale Unterschied zwischen Stichproben- und Populationsebene noch nicht ganz klar sein sollte oder du dich fragst, warum man überhaupt statistische Tests durchführt, dann schau dir gerne unseren Blogartikel zu diesem Thema  an.  


    Die Logik des Chi-Quadrat-Tests ist (wie häufig in der Statistik) eigentlich ziemlich simpel. Die Nullhypothese lautet, dass die beiden Variablen auf Populationsebene unabhängig voneinander sind (also kein Zusammenhang besteht). Die Alternativhypothese lautet (wenig überraschend), dass ein Zusammenhang besteht.

    Im Prinzip werden nun einfach die tatsächlich aufgetretenen absoluten Häufigkeiten mit jenen Häufigkeiten verglichen, die man erwarten würde, wenn kein Zusammenhang zwischen den Variablen bestünde (wie man diese bei Unabhängigkeit erwarteten Häufigkeiten bekommt ist am dieser Stelle nicht wichtig).


    Diese Abweichungen zwischen den tatsächlichen und den bei Unabhängigkeit erwarteten Häufigkeiten werden quadriert (deshalb Chi-Quadrat), summiert und auf bestimmte Weise normiert und schon haben wir unsere Teststatistik, die ebenfalls χ2 heißt.


    Je größer die Teststatistik χ2 ist, umso größer sind offenbar auch die Abweichungen zwischen den tatsächlich aufgetretenen und den bei Unabhängigkeit erwarteten Häufigkeiten und umso unwahrscheinlicher ist es, dass auf Populationsebene kein Zusammenhang zwischen den beiden Variablen besteht. Für unsere Teststatistik können wir uns dann (wie bei jedem anderen Test auch) einfach den zugehörigen p-Wert anschauen und beurteilen, ob ein statistisch signifikantes Ergebnis vorliegt oder nicht.


    Für unser Beispiel bekommen wir ein χ2 = 6.003 mit einem zugehörigen p-Wert von p = .0143. Wenn wir unser „Signifikanzniveau“ (die Wahrscheinlichkeit für den Fehler 1. Art, kurz α) wie üblich auf α = .05 festgelegt haben, haben wir also ein signifikantes Testergebnis (da p < .05).


    Wir sollten uns also dafür entscheiden, dass auf Populationsebene ein Zusammenhang zwischen der Wirksamkeit des Medikaments und dem Geschlecht besteht. Oder anders formuliert: Das Medikament wirkt bei den beiden Geschlechtern unterschiedlich.

    Inhaltliche Interpretation


    Für die klinische Praxis ist das Ergebnis, dass ein Zusammenhang zwischen zwei Variablen besteht, allerdings meistens etwas unbefriedigend, da man natürlich genauer wissen möchte, wie dieser Zusammenhang denn konkret aussieht.


    Anders gesagt: Wenn du bei Zusammenhangsanalysen mit kategorialen Variablen  einfach nur den Chi-Quadrat-Test durchführst und dich dann bei einem signifikanten Ergebnis zurücklehnst, verpasst du die eigentlich klinisch relevanten Informationen. Du solltest stattdessen weitere Analysen durchführen, um den gefundenen Zusammenhang inhaltlich genauer beschreiben und interpretieren zu können.


    Glücklicherweise ist unser Beispiel so einfach aufgebaut, dass für eine genauere Beschreibung des gefundenen Zusammenhangs ein Blick auf die erstellten Häufigkeitstabellen genügt. Da beide Variablen (Geschlecht und Medikamentenwirksamkeit) jeweils nur zwei Ausprägungen haben, gibt es auch nur zwei Möglichkeiten, wie der gefundene Zusammenhang zwischen Geschlecht und Medikamentenwirksamkeit inhaltlich interpretiert kann:


    1. das Medikament ist wirksamer bei den Frauen oder
    2. das Medikament ist wirksamer bei den Männern.


    Und unsere bedingte Häufigkeitstabelle zeigt ja, dass der Zusammenhang hier so aussieht, dass das Medikament bei den Frauen wirksamer ist als bei den Männern.

    Wenn in deiner Untersuchung allerdings eine der beiden Variablen mehr als zwei Kategorien haben sollte (z.B. weiblich, männlich und divers beim Geschlecht), wird die Sache etwas komplexer.

    Denn nun gibt es natürlich viel mehr Möglichkeiten, wie der gefundene Zusammenhang inhaltlich aussehen kann. Und ein Blick auf die Häufigkeitstabellen reicht hier leider nicht, um herauszufinden, welche dieser Möglichkeiten zutrifft. 

    Um einen signifikanten Chi-Quadrat-Test in diesem Fall klinisch-inhaltlich sinnvoll und praxisrelevant interpretieren zu können, ist es in aller Regel notwendig, weitere post-hoc-Analysen durchzuführen.

    Effektstärkemaße: Cramérs V und Odds-Ratio (OR)


    Zusätzlich zu dem p-Wert und der Aussage, dass ein signifikantes Testergebnis vorliegt, ist es natürlich auch hilfreich, etwas mehr über die Größe des Effekts — also die „Stärke“ des gefundenen Zusammenhangs — sagen zu können. Die Größe der Teststatistik bzw. der p-Wert allein reicht für eine Beurteilung nicht aus, da beide (wie so oft in statistischen Tests) unter anderem von der Größe deiner Stichprobe abhängig sind.  


    Das für alle Fälle geeignetste Maß der Effektstärke für einen Chi-Quadrat-Test ist Cramérs V, das immer nur Werte zwischen 0 und + 1 annehmen kann. Ein V = 0 bedeutet dabei, dass keinerlei Zusammenhang vorliegt, ein V = 1, dass ein „perfekter“ oder „vollständiger“ Zusammenhang vorliegt.


    Für die Beurteilung der Effektgröße V kannst du dich einfach an den Konventionen von Cohen (1988) zur Beurteilung der Größe der Korrelation orientieren:

    • kleiner Effekt: ab V = .1
    • mittlerer Effekt: ab V = .3
    • großer Effekt: ab V = .5


    In unserem Beispiel ist V = .173, was sich nach diesen Konventionen als „kleiner Effekt“ beurteilen lässt.


    In der klinischen Praxis gibt man aufgrund der besseren Interpretierbarkeit häufig auch das Odds-Ratio (OR) als Maß der Effektstärke an. Wie der Name schon andeutet handelt es sich hier um das Verhältnis (ratio) zweier odds, was man auch mit „Chance“ übersetzen könnte.


    Was ist damit gemeint? Schauen wir uns wieder die absolute Häufigkeitstabelle unseres Beispiels an:


      Männer Frauen Σ
    wirksam 43 82 125
    nicht wirksam 39 36 75
    Σ 82 118 200


      Männer Frauen Σ
    wirksam 43 82 125
    nicht wirksam 39 36 75
    Σ 82 118 200


    Die Chance, dass das Medikament bei Männer wirksam ist, ist gerade die Anzahl der Männer, bei denen das Medikament wirksam war, geteilt durch die Anzahl der Männer, bei denen es nicht wirksam war, also:


    43/39 = 1.103


    Klar: Wenn das Medikament bei genauso vielen Männern wirksam wie nicht wirksam wäre, dann wäre die Chance der Wirksamkeit bei den Männern gerade Eins. Wenn es sogar bei mehr Männern nicht wirksam wäre, wäre die Chance kleiner Eins.


    In der Gruppe der Frauen berechnet sich die entsprechende Chance analog und man erhält hier den Wert


    82/36 = 2.278


    Bei beiden Geschlechtern ist also die Chance, dass das Medikament wirksam ist, größer als Eins (was auf eine generelle Wirksamkeit des Medikaments hindeutet), bei den Frauen ist die Chance jedoch deutlich höher.

    Das Odds–Ratio berechnet sich nun ganz einfach als das Verhältnis dieser beiden Chancen. Welche der beiden Möglichkeiten du berechnen und als Effektstärke präsentieren solltest (Chance der Wirksamkeit bei den Männern geteilt durch Chance der Wirksamkeit bei den Frauen oder genau anders herum) hängt allein davon ab, welche inhaltliche Interpretation du für deinen Fall bevorzugst.


    Spielen wir einfach mal beide Varianten für unser Beispiel durch:


    1. Variante: Chance der Männer geteilt durch Chance der Frauen. In diesem Fall erhalten wir ein Odds-Ratio von


    OR = 1.103/2.278 = 0.484.


    Was sagt uns das? Das bedeutet, dass die Chance, dass das Medikament bei Männern wirksam ist, nur etwa halb so hoch ist wie bei den Frauen.


    1. Variante: Chance der Frauen geteilt durch Chance der Männer. In diesem Fall erhalten wir ein Odds-Ratio von


    OR =  2.278/1.103 = 2.065


    Das bedeutet offenbar, dass die Chance, dass das Medikament bei Frauen wirksam ist, etwa doppelt so hoch ist wie bei den Männern.


    Du siehst, beide Aussagen sagen im Prinzip das Gleiche, nur auf unterschiedliche Art und Weise. In der Praxis ist häufig die Interpretation eines Odds-Ratios größer als Eins leichter nachzuvollziehen als ein Odds-Ratio kleiner Eins.   

    Was es noch zu beachten gibt …


    Besonders wichtig ist, dass du den Chi-Quadrat-Test nur dann sinnvoll durchführen kannst, wenn du unabhängige Stichproben hast, wie in unserem Beispiel. Das bedeutet, dass jede deiner PatientInnen nur in einer Zelle deiner Häufigkeitstabelle auftauchen darf. Jeder Patient ist entweder männlich oder weiblich und entweder war das Medikament wirksam oder nicht.


    Unabhängige Stichproben/Beobachtungen liegen z.B. nicht vor, wenn du ein Messwiederholungsdesign hast und die gleichen Patient:innen zu mehreren Messzeitpunkten untersucht werden. Hier spricht man dann auch von abhängigen Stichproben. Abhängige Stichproben sind aber kein Grund zum Verzweifeln, denn dann kannst du statt des Chi-Quadrat-Tests McNemars-Test zur Analyse verwenden.


    Solltest du insgesamt eine „recht kleine“ Stichprobe haben (Daumenregel: N < 20) oder sollten die Häufigkeiten in einer oder mehrerer Zellen deiner Häufigkeitstabelle „recht klein“ sein (Daumenregel: weniger als 5), dann kannst du sowohl für den Chi-Quadrat-Test als auch für McNemars-Test bestimmte Korrekturmethoden verwenden, um einer Verzerrung der Ergebnisse durch die geringe Stichprobengröße entgegenzuwirken.      

    Zusammenhänge verstehen: Die Korrelationsanalyse in der medizinischen Statistik

    Zusammenhänge verstehen: Die Korrelationsanalyse in der medizinischen Statistik

    Zusammenhänge verstehen: Die Korrelationsanalyse in der medizinischen Statistik

    • Warum werden in der medizinischen Statistik eigentlich so häufig Korrelationen berechnet? Und was genau ist eine Korrelation?
    • Kann man Korrelationen immer berechnen? Und was sollte man bei der Berechnung und Interpretation von Korrelationen beachten?
    • Was sind Scheinkorrelationen und verdeckte Korrelationen?
    • Und warum sind Korrelation und Kausalität nicht das Gleiche?

    In diesem Artikel werden wir diese Fragen beantworten (und noch viel mehr!), ohne dass du dafür tiefere statistische Kenntnisse benötigst.

    Aber zunächst noch ein Hinweis, bevor es losgeht:
    Wenn man in der Statistik von „der Korrelation“ spricht, meint man in der Regel die Korrelation nach Pearson (kurz: Pearson-Korrelation oder auch Produkt-Moment-Korrelation). Es gibt allerdings auch für spezielle (und deutlich seltenere) Fälle andere Korrelationsarten, die man berechnen kann. Wir werden diese Fälle ganz am Schluss dieses Artikels behandeln. Bis dahin ist mit „Korrelation“ immer die Pearson-Korrelation gemeint.


    Ganz wichtig:
    Um die Pearson-Korrelation zwischen zwei Merkmalen sinnvoll berechnen zu können, sollten beide Variablen mindestens intervallskaliert sein.

    Zusammenhang und linearer Zusammenhang

    In der medizinischen Statistik findet man häufig Untersuchungsfragen der Art „Gibt es einen Zusammenhang zwischen der Dosis von Medikament X und der Herzfrequenz (oder der Stärke von Kopfschmerzen, der Dauer einer Infektion, oder, oder, oder)?“


    Eine (!) Möglichkeit, Fragen dieser Art nachzugehen, ist die Korrelationsanalyse. Der Knackpunkt solcher Fragestellungen ist, dass das Wort „Zusammenhang“ aus statistischer Perspektive ziemlich viele Bedeutungen haben kann. Mit einer Korrelationsanalyse untersucht man allerdings nur eine ganz bestimmte Form des Zusammenhangs, nämlich den linearen Zusammenhang zwischen zwei Variablen. Ganz allgemein dient die Korrelation dazu, die Stärke des linearen Zusammenhangs zwischen zwei Merkmalen zu quantifizieren, also in einer Zahl auszudrücken.


    Aber was genau ist ein linearer Zusammenhang? Das wollen wir dir gleich an einem einfachen Beispiel erklären.


    Angenommen, du möchtest den Zusammenhang zwischen der Dosis eines Medikaments und der Herzfrequenz untersuchen. Du erhebst dazu nun bei 100 Personen beide Merkmale und schaust dir die erhobenen Daten anschließend anhand eines Streudiagramms (einer Punktwolke) an. Du solltest dir übrigens immer, wenn es um die Analyse von Zusammenhängen zwischen zwei Variablen geht, deine Daten grafisch veranschaulichen. Warum du das tun solltest, wird gleich deutlich werden.


    Die folgende Grafik zeigt dir sechs mögliche (und natürlich vollkommen fiktive) Punktwolken, die man für dieses Beispiel bekommen könnte. Es gibt natürlich noch unzählige andere Möglichkeiten, wie die Punktwolke aussehen könnte.

    Ohne große statistische Kenntnisse zu haben, könnte man die Punktwolken nun folgendermaßen beschreiben:


    Fall a) Hier lässt sich ein deutlicher Zusammenhang erkennen. Mit einer höheren Dosis geht tendenziell auch eine höhere Herzfrequenz einher. Man spricht hier auch von einem positiven linearen Zusammenhang („je mehr von dem einen, desto mehr von dem anderen“).


    Fall b) Hier lässt sich ebenfalls ein deutlicher Zusammenhang erkennen. Mit einer höheren Dosis geht hier jedoch tendenziell eine niedrigere Herzfrequenz einher. Man spricht hier auch von einem negativen linearen Zusammenhang („je mehr von dem einen, desto weniger von dem anderen“).


    Fall c) Hier lässt sich ebenfalls ein deutlicher Zusammenhang erkennen. Der Zusammenhang ist hier allerdings nicht linear, sondern „komplexer“. Man nennt das manchmal auch einen „U-förmigen“ oder auch quadratischen Zusammenhang.  Inhaltlich bedeutet das hier, dass mit niedrigeren Dosen eine höhere Herzfrequenz einhergeht, die Herzfrequenz dann allerdings mit zunehmender Dosis (nicht linear) abnimmt und dann ab einer gewissen Dosis wieder (nicht-linear) zunimmt.


    Fall d) Hier lässt sich ebenfalls ein deutlicher Zusammenhang erkennen, dieser ist aber auch komplexer als in den Fällen a) und b). Hier steigt die Herzfrequenz zwar zunächst mit der Dosis, ab einer bestimmten Dosis verringert sich dann jedoch die Herzfrequenz mit zunehmender Dosis.


    Fall e) Hier lässt sich kein Zusammenhang erkennen. Unabhängig von der Dosis bleibt die Herzfrequenz im Großen und Ganzen konstant.


    Fall f) Hier lässt sich kein Zusammenhang erkennen. Die Punkte scheinen vollkommen zufällig verteilt zu sein.


    Die Sache mit der Korrelationsanalyse ist nun, dass Zusammenhänge wie in Fall c) und d) dargestellt, nicht von der Korrelation „erfasst“ werden. Heißt: Man sieht sofort, dass ein ziemlich eindeutiger Zusammenhang vorliegt, berechnet man jedoch die Korrelation, dann wäre diese in etwa so hoch wie in den Fällen e) und f), bei denen kein Zusammenhang vorliegt.

    Daher unbedingt merken:


    1. Mit der Korrelation erfasst man nur den linearen Zusammenhang zwischen zwei Merkmalen. Vereinfacht gesagt heißt „linear“ dabei, dass man, wie du in Fall a) und b) sehen kannst, die Punktwolke gut durch eine Gerade repräsentieren kann, die einen positiven (wie in Fall a) oder negativen (wie in Fall b) Anstieg hat. Liegt ein anderer Typ von Zusammenhang vor (wie in Fall c und d), dann ist die Berechnung der Korrelation nicht sinnvoll.
    2. Daher solltest du dir bei der Analyse von Zusammenhängen zwischen zwei Merkmalen als ersten Schritt deine Daten immer grafisch veranschaulichen, um beurteilen zu können, ob die Berechnung der Korrelation überhaupt sinnvoll ist.

    Nachdem wir diesen wichtigen Punkt geklärt haben, werden wir uns nun anschauen, welche Werte die Korrelation überhaupt annehmen kann und wie die Größe der Korrelation mit der „Form“ der zugehörigen Punktwolke zusammenhängt.


    Interpretation der Korrelation


    Angenommen, du hast dir also nun deine Daten grafisch veranschaulicht und die Berechnung der Korrelation ist tatsächlich sinnvoll (heißt: es liegt kein nicht-linearer Zusammenhang vor). Was bedeutet dann die Größe der Korrelation?


    Die Korrelation soll die Stärke des linearen Zusammenhangs in einer Zahl ausdrücken. Daher wäre es nützlich, wenn


    1. die Korrelation den Wert 0 annimmt, wenn kein linearer Zusammenhang vorliegt,
    2. die Korrelation umso größer wird, je größer der lineare Zusammenhang ist
    3. du anhand der Korrelation sehen kannst, ob ein positiver linearer Zusammenhang („je mehr von dem einen, desto mehr auch von dem anderen“) oder ein negativer linearer Zusammenhang („je mehr von dem einen, desto weniger von dem anderen“) vorliegt, und
    4. die Größe der Korrelation unabhängig von Einheit, Mittelwert und Standardabweichung der beiden Variablen wäre, sodass die Interpretation der Größe der Korrelation für jede mögliche Untersuchungssituation immer die gleiche ist und du somit auch Korrelationen aus unterschiedlichen Studien miteinander vergleichen kannst.

    Glücklicherweise erfüllt die Korrelation all diese Eigenschaften! Danke, Statistik! 😉


    Normierung des Korrelationskoeffizienten

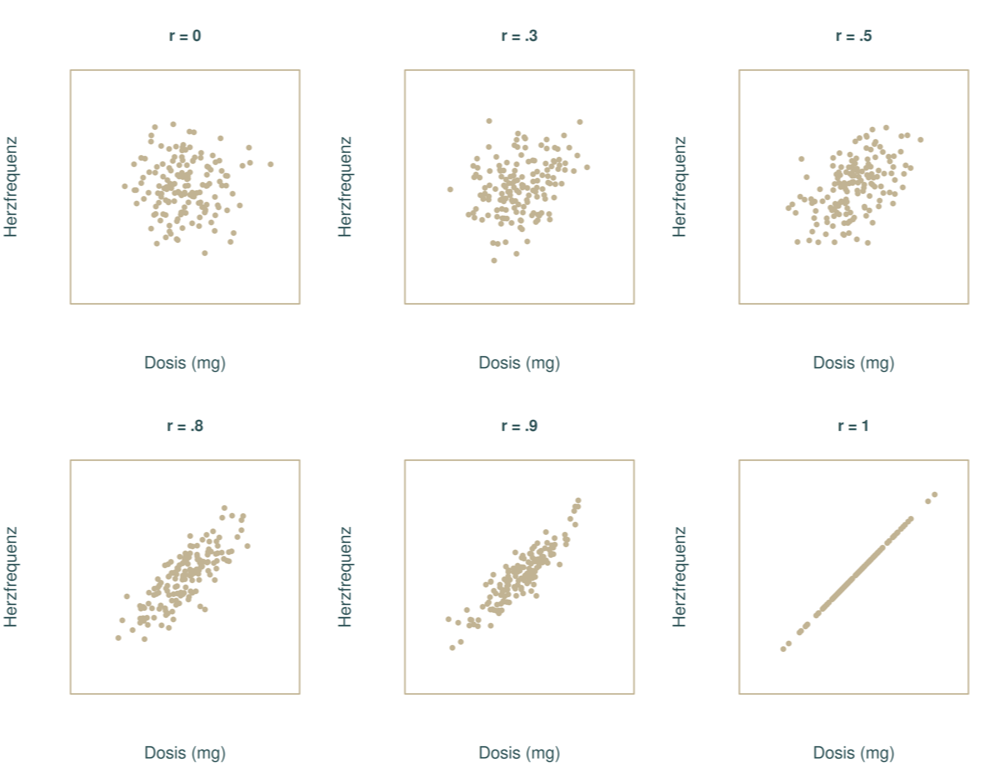
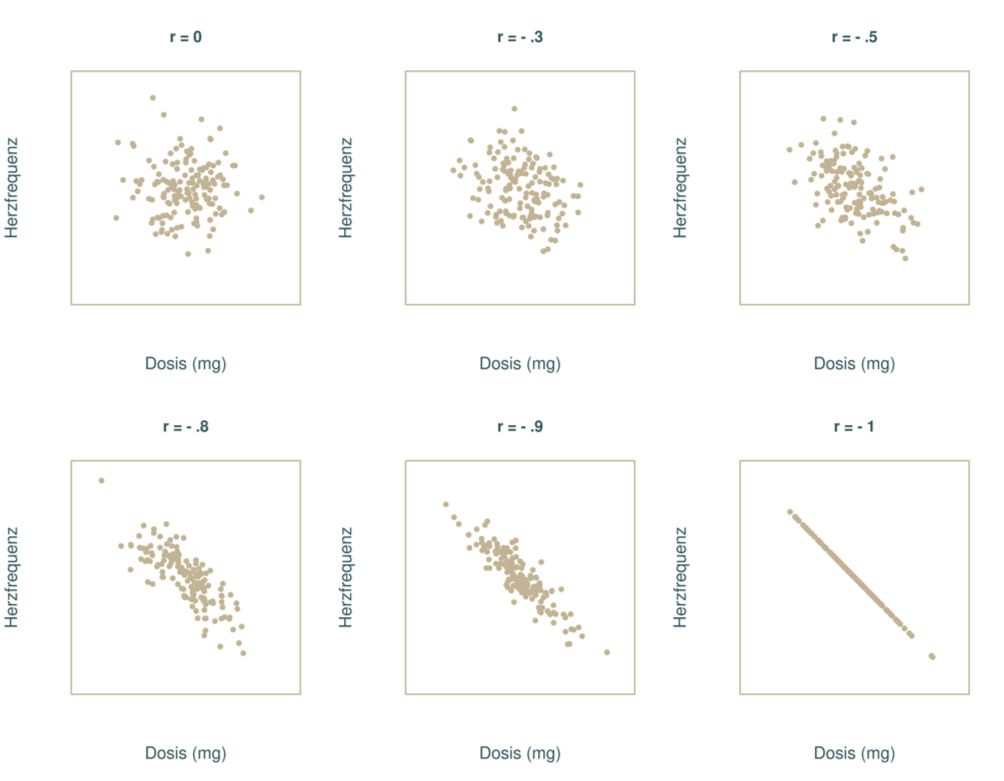
    Berechnest du die Korrelation, dann liegt diese immer im Bereich zwischen  -1 und +1. Das Vorzeichen gibt dir dabei an, ob ein positiver (+) oder ein negativer (-) linearer Zusammenhang zwischen den beiden Merkmalen vorliegt. Ist die Korrelation 0, liegt kein linearer Zusammenhang vor. Je näher die Korrelation bei den beiden „Endpunkten“ +1 bzw. -1 liegt, umso „stärker“ ist auch der positive bzw. negative lineare Zusammenhang zwischen beiden Variablen. Ist die Korrelation genau +1 oder -1, dann liegen sämtliche Punkte der Punktwolke auf einer Geraden (mit positivem oder negativem Anstieg).


    In den folgenden Grafiken kannst du einen Eindruck davon bekommen, wie für verschiedene mögliche „Punktwolkenformen“ die zugehörige Größe der Korrelation aussieht.

    Die Korrelation zwischen zwei Variablen wird in der Statistik auch kurz mit r bezeichnet und steht hier über der jeweiligen Punktwolke.

    Wir beginnen mit Beispielen für die positive Korrelation: 


    Und hier das Gleiche noch einmal für die negative Korrelation:

    Man kann hier wunderbar sehen, dass mit zunehmender Größe der Korrelation die Form der Punktwolke immer „schmaler“ wird und sich immer weiter einer Geraden annähert.


    Bei einer Korrelation von +1 oder -1, also wenn alle Punkte auf einer Geraden liegen, spricht man auch von einem „perfekten linearen Zusammenhang“ oder auch von einem „deterministischen Zusammenhang“. Dieser Fall wird natürlich in Praxis so gut wie nie auftreten (und bei Patientendaten schon dreimal nicht).


    Zur weiteren Interpretation der Größe der Korrelation greift man häufig auf eine Konvention von Cohen (1988) zurück, nach der es sich bei Korrelationen von

    • .1 ≤ |r| < .3 um „kleine Zusammenhänge“
    • .3 ≤ |r| < .5 um „mittlere Zusammenhänge“ und
    • |r| > .5 um „große Zusammenhänge“

    handelt (|r| steht hier für die absolute Größe der Korrelation, also unabhängig vom Vorzeichen).

    WICHTIG: Eine Korrelation von 0 oder nahe 0 bedeutet NICHT zwangsläufig, dass kein Zusammenhang zwischen den beiden Merkmalen besteht, sondern eben nur, dass kein linearer Zusammenhang besteht. Würdest du etwa die Korrelation von Fall c) von oben berechnen, dann würdest du eine Korrelation von fast 0 (r = – 0.0034, wenn du es genau wissen möchtest) bekommen, obwohl ein nahezu perfekter, aber eben nicht-linearer, Zusammenhang zwischen Dosis und Herzfrequenz besteht!

    Um diesen Punkt nochmal anschaulich zu verdeutlichen zeigt die folgende Graphik wieder die Punktwolke von Fall c), diesmal ist zusätzlich die zugehörige Regressionsgerade eingezeichnet.

    Das Thema dieses Artikels ist zwar die Korrelation, aber es besteht ein enger inhaltlicher Zusammenhang zwischen der Korrelation und der einfachen linearen Regression. Ganz einfach gesprochen lässt sich anhand des Anstiegs der Regressionsgeraden die „Richtung“ der Korrelation ablesen. Liegt eine positive Korrelation vor, ist auch der Anstieg der Regressionsgeraden positiv. Liegt hingegen eine negative Korrelation vor, ist auch der Anstieg der Regressionsgeraden negativ. Bei einer Korrelation von 0 hat die Regressionsgerade einen Anstieg von 0, ist also einfach nur eine „waagerechte Linie“, wie es hier in Fall c) vorliegt. 


    Außerdem solltest du bei der Interpretation deiner Korrelation auch nicht in die folgenden Fallen stolpern…


    Stolperfallen bei der Interpretation


    1. Korrelation vs. Kausalität


    Dass Korrelation und Kausalität zwei verschiedene Paar Schuhe sind hast du vermutlich schon einmal gehört. Die Korrelation ist erst einmal nichts anderes als eine formal-statistische Eigenschaft zwischen zwei Variablen und sagt für sich genommen überhaupt nichts über irgendwelche möglichen Ursache-Wirkungszusammenhänge aus.


    Beispielsweise wurde in ziemlich vielen (und ziemlich oft zitierten) Studien eine positive Korrelation zwischen dem Spielen von Ego-Shootern und der Aggressionsbereitschaft gefunden. Aber heißt das nun, dass das vermehrte Spielen von Ballerspielen die höhere Aggressionsbereitschaft kausal verursacht? Und sollte man deshalb nicht besser alle Ballerspiele verbieten?


    Diese Frage ist schwer zu beantworten, aber sie lässt sich definitiv nicht allein über Korrelationsanalysen beantworten. Es ist natürlich möglich, dass das Spielen von Ballerspielen die Aggressionsbereitschaft erhöht. Ebenso möglich ist es allerdings auch, dass Personen mit erhöhter Aggressionsbereitschaft eben gerne Ballerspiele spielen. Und es kann natürlich auch sein, dass ein oder mehrere andere Faktoren (z.B. genetische Dispositionen) sowohl die erhöhte Aggressionsbereitschaft als auch die Liebe zu Ballerspielen verursacht.


    Es gibt selbstverständlich auch Fälle, bei denen bestimmte Möglichkeiten von vornherein unplausibel sind. In unserem Beispiel ist es etwa ziemlich unplausibel, dass eine erhöhte Herzfrequenz eine höhere Medikamentendosis „verursacht“.


    Als Faustregel kannst du dir aber merken: Du solltest generell die Korrelation zwischen zwei Merkmalen für sich allein genommen nicht kausal interpretieren.

    2. Scheinkorrelationen


    Häufig findet man auch substanzielle Korrelationen zwischen Merkmalen, die in keinerlei (theoretischem) Bezug zueinanderstehen. So lässt sich etwa ein fast perfekter linearer Zusammenhang (r = .996) zwischen der Scheidungsrate in Maine (Bundesstaat in den USA) und dem Margarinekonsum pro Kopf in den USA feststellen. Ein Fall für die nächste Ausgabe von Science? Besser nicht…


    Solche Korrelationen bezeichnet man auch als Scheinkorrelationen. Der Punkt dabei ist, dass man alles Mögliche miteinander korrelieren kann und dann eben hin und wieder auch durchaus substanzielle Korrelationen findet, die aber auf inhaltlich-theoretischer Ebene vollkommen bedeutungslos oder „zufällig“ sind.


    Für dich heißt das: Du solltest in deinen Daten nicht einfach alle möglichen Korrelationen berechnen (nur weil die lediglich einen Klick entfernt sind und du es kannst), sondern wie auch bei allen anderen statistischen Analysen immer theoriegeleitet vorgehen. Das heißt, du solltest aufgrund klinisch-theoretischer Überlegungen begründete Vermutungen haben, warum bestimmte Merkmale in einem Zusammenhang stehen sollen.


    Eine wirklich nette Zusammenstellung wirklich lustiger Scheinkorrelationen lässt sich übrigens unter

    https://www.tylervigen.com/spurious-correlations

    finden.

    3. Verdeckte Korrelationen/Simpson-Paradox


    Ein weiterer Punkt, den du bei Korrelationsanalysen stets beachten solltest, ist, dass deine berechnete Korrelation nicht „absolut“ zu verstehen ist. Was ist damit gemeint? Das lässt sich am besten wieder anhand eines einfachen Beispiels erklären, das auch als „Simpson-Paradox“ bekannt ist (obwohl es sich genau genommen gar nicht um ein Paradoxon handelt, aber es klingt halt toll).


    Nehmen wir mal an, du hättest für unser Beispiel von oben (Medikamentendosis und Herzfrequenz) folgende Punktwolke bekommen (zur Verdeutlichung ist auch hier wieder die zugehörige Regressionsgerade eingezeichnet):

    Berechnest du jetzt für diese Daten die Korrelation zwischen Medikamentendosis und Herzfrequenz, dann ist diese hier r = – 0.54. Es besteht also ein recht großer negativer linearer Zusammenhang, was du auch an dem negativen Anstieg der Regressionsgerade ablesen kannst.


    Nehmen wir weiter an, du würdest jetzt die Männer und die Frauen deiner Stichprobe (farblich) getrennt betrachten und bekämst dann folgende Punktwolke:

    Beachte, dass die Datenpunkte bei beiden Punktwolken vollkommen identisch sind! Würdest du jetzt aber die Korrelation zwischen Dosis und Herzfrequenz für die Männer und Frauen getrennt berechnen, dann wäre die sowohl für die Männer als auch für die Frauen in etwa r = 0.6, also jeweils ein recht großer positiver linearer Zusammenhang! Dass es sich hier um jeweils positive lineare Zusammenhänge handelt kannst du wiederum an den beiden Regressionsgeraden ablesen, die hier für die Frauen und die Männer getrennt eingezeichnet sind.


    Was soll dir dieses Beispiel zeigen? Wenn du Korrelationsanalysen durchführst, dann ist das Ergebnis immer von deiner konkreten „Datenkonstellation“ abhängig, und zwar insbesondere von weiteren Variablen, die du in deine Analyse(n) mit einbeziehst (in dem Beispiel das Geschlecht).


    Das Problem ist allerdings, dass du bei der Datenerhebung natürlich gar nicht vollständig wissen kannst, welche Variablen für die Analyse wichtig sein könnten. So könnte etwa in unserem Beispiel der lineare Zusammenhang zwischen Dosis und Herzfrequenz wieder anders aussehen, wenn man jetzt noch zusätzlich getrennt nach sozioökonomischem Status, Vorliegen einer bestimmten Krankheit, BMI usw. auswerten würde.

    Du siehst also, die eigentliche Schwierigkeit bei Zusammenhangsanalysen besteht nicht darin, diese durchzuführen (das macht ein Programm für dich), sondern die Ergebnisse klinisch-inhaltlich angemessen zu interpretieren! 

    Und dafür ist auch (wieder mal) der Unterschied zwischen Stichprobe und Population wichtig!

    Stichprobe und Population


    Bisher haben wir ja nur darüber gesprochen, wie man für eine konkrete Stichprobe die Korrelation berechnet. In der Regel möchtest du aber nicht (nur) wissen, ob ein linearer Zusammenhang zwischen zwei Merkmalen deiner Stichprobe besteht, sondern ob ein solcher Zusammenhang in der Population, aus der deine Stichprobe stammt, existiert. Oder kurz gesagt: Du möchtest einen inferenzstatistischen Test durchführen.


    In unserem Beispiel möchtest du also nicht nur wissen, ob sich ein Zusammenhang zwischen Medikamentendosis und Herzfrequenz bei den 100 von dir untersuchten Personen finden lässt, sondern eben ganz allgemein, auf alle Personen bezogen.


    Glücklicherweise folgt auch der Korrelationstest der üblichen Logik inferenzstatistischer Tests, die du in unserem Grundlagenartikel dazu nachlesen kannst.


    Die Korrelation auf Populationsebene wird mit ρ (sprich: rho) bezeichnet und die Null- und Alternativhypothese für diesen Test lauten demzufolge:

    H0: ρ = 0

    H1: ρ ≠0

    Die H0 besagt also, dass auf Populationsebene kein linearer Zusammenhang besteht und die (ungerichtete) H1 besagt, dass ein linearer Zusammenhang besteht, wobei nicht spezifiziert ist, ob dieser positiv oder negativ ist. Gelegentlich findet man auch Situationen, in denen die H1 gerichtet ist, also spezifisch auf einen positiven bzw. negativen linearen Zusammenhang getestet wird.


    Als Ergebnis deines Tests bekommst du wieder einen p-Wert und wenn dieser kleiner ist als dein α, dann solltest du die H0 verwerfen. Und hier gilt natürlich auch wieder, dass der p-Wert von der Stichprobengröße beeinflusst wird und du dein Ergebnis auf den 3 Ebenen statistische Signifikanz, Effektgröße und klinische Bedeutsamkeit interpretieren solltest. Falls dir das alles nichts sagt: Das alles ist ausführlich in unserem Grundlagenartikel erklärt!


    Was du tun kannst, wenn deine beiden Variablen nicht intervallskaliert sind, erklären wir dir nun im letzten Abschnitt.

    Spezialfälle der Korrelation


    Wenn deine beiden Merkmale nicht intervallskaliert sind, dann lassen sich glücklicherweise trotzdem Zusammenhangsanalysen durchführen, in denen nicht die Produkt-Moment-Korrelation, sondern eine andere „Korrelationsvariante“ berechnet werden kann. Ohne näher darauf einzugehen, wie genau diese verschiedenen Varianten berechnet werden, wollen wir dir hier eher einen Überblick anbieten.


    1. Fall: Eine intervallskalierte und eine ordinalskalierte Variable oder zwei ordinalskalierte Variablen

    Für diesen Fall lässt sich die Rangkorrelation, auch Spearman-Korrelation genannt, berechnen. Auch diese liegt immer zwischen – 1 und +1 und lässt sich prinzipiell so interpretieren wie die Produkt-Moment-Korrelation.


    Die Spearman-Korrelation ist mit Abstand der am häufigsten auftretende „Spezialfall“ und nach der Produkt-Moment-Korrelation die am zweithäufigsten verwendete Art der Korrelationsanalyse.


    2. Fall: Eine intervallskalierte Variable und eine dichotome Variable

    Hier lässt sich die punktbiseriale Korrelation berechnen, auch diese liegt immer zwischen  -1 und +1. Die Interpretation hängt hier davon ab, welche Ausprägung der dichotomen Variable mit ‚0‘ und welche mit ‚1‘ kodiert ist. Eine positive punktbiseriale Korrelation bedeutet dabei, dass ein positiver Zusammenhang zwischen der intervallskalierten Variable und der Ausprägung der dichotomen Variable, die mit ‚1‘ kodiert ist, vorliegt. Wurde beispielsweise das Geschlecht (0 = Männer, 1 = Frauen) und die Herzfrequenz erhoben und du bekommst eine positive punktbiseriale Korrelation, dann bedeutet das inhaltlich, dass die Frauen deiner Stichprobe eine höhere Herzfrequenz aufweisen als die Männer (und bei einer negativen Korrelation genau andersherum).


    Gelegentlich gibt es auch Situationen, in denen eine intervallskalierte Variable künstlich dichotomisiert wird. So könnte man etwa das Alter von Patienten lediglich in 2 Kategorien („jung“ und „alt“) einteilen. Für diesen Spezialfall (eine intervallskalierte und eine künstlich dichotomisierte Variable) lässt sich auch die biseriale Korrelation berechnen.


    Die biseriale Korrelation kann auch Werte außerhalb des Bereiches zwischen -1 und +1 annehmen. Zusätzlich ist die Berechnung nur dann sinnvoll, wenn die beiden intervallskalierten Variablen normalverteilt sind. Im Zweifel solltest du daher stets die punktbiseriale Korrelation vorziehen.


    3. Fall: Eine ordinalskalierte Variable und eine dichotome Variable

    In diesem Fall lässt sich die biseriale Rangkorrelation berechnen. Der Wertebereich ist hier wieder zwischen -1 und +1 und die Interpretation analog zur punktbiserialen/biserialen Korrelation.


    4. Fall: Zwei dichotome Variablen

    Hast du zwei dichotome Variablen, dann kannst du den Φ-Koeffizienten (sprich: phi) oder Cramérs V bestimmen. Beide Größen sind ist eng verwandt mit dem Kontingenzkoeffizienten χ2 (sprich: Chi2), der sich allgemein für zwei kategoriale/qualitative Variablen berechnen lässt. Der Φ-Koeffizient kann auch Werte außerhalb des Bereiches zwischen -1 und +1 annehmen und die Interpretation des Koeffizienten hängt hier wesentlich von der Kodierung der beiden dichotomen Variablen ab.


    Möchtest du den Φ–Koeffizienten oder Cramérs V im Rahmen des χ2-Tests berechnen, haben wir hier einen Onlinekurs zum Thema erstellt.


    Wir haben dir zum besseren Überblick die verschiedenen Korrelationsarten bei unterschiedlichen Skalentypen der beiden Variablen in folgender Tabelle noch einmal zusammengefasst.

    Variable 1

    Variable 2 Intervall Ordinal Dichotom
    Intervall Pearson-Korrelation

    Rangkorrelation
    (Spearman)

    Punktbiseriale Korrelation
    Ordinal


    –

    Rangkorrelation (Spearman)  Biseriale Rangkorrelation
    Dichotom


    –


    –


    Φ-Koeffizient


    Da die Berechnung einer Korrelation (egal welche) wirklich nur einen Klick erfordert und du aber durch simples Anklicken und Berechnen leider auch schnell in eine der dargestellten Stolperfallen taumeln kannst, solltest du, wenn du Zusammenhangsanalysen durchführst, bestenfalls immer nach dem folgenden Schema vorgehen:


    1. Überlege dir vorher, welche inhaltlich-theoretischen Vermutungen du bzgl. des Zusammenhangs zwischen den beiden Merkmalen hast und warum du diese hast! Gibt es vielleicht noch eine Variable, die du zusätzlich mit in deine Analysen einbeziehen solltest (siehe Simpson-Paradox)?
    2. Veranschauliche dir deine Daten in einer Grafik (ja, unbedingt)!
    3. Überlege anhand der graphischen Veranschaulichung deiner Daten, ob die Berechnung einer Korrelation überhaupt für deinen Fall sinnvoll ist!
    4. Berechne die Korrelation und führe ggf. einen statistischen Test durch!
    5. Interpretiere die Korrelation und das Testergebnis auf den 3 Ebenen statistische Signifikanz, Effektgröße und inhaltlich-klinische Bedeutsamkeit!

    Nicht-lineare Zusammenhänge analysieren


    Falls du bei der graphischen Veranschaulichung deiner Daten feststellen solltest, dass bei dir ein nicht-linearer Zusammenhang (z.B. ein quadratischer wie in Fall c) von oben) vorliegt, dann solltest du natürlich die Korrelation nicht berechnen (weder die Korrelation nach Pearson noch die nach Spearman)! Aber was kannst du in diesem Fall alternativ verwenden, um die Größe des Zusammenhangs zwischen deinen beiden Variablen zu beschreiben?


    Hier kommt es ein wenig darauf an, was das genaue Ziel deiner Untersuchung ist. Möchtest du die Daten eher in einem Regressionskontext analysieren, dann könntest du auf nichtlineare oder polynomiale Regressionen zurückgreifen. Beides sind recht komplexe Verfahren, die wir dir an anderer Stelle erklären.  Wenn du allerdings „lediglich“ die Stärke des Zusammenhangs zwischen deinen beiden Variablen erfassen und inferenzstatistisch testen möchtest, dann ist die sog. Distanzkorrelation (distance correlation) die Methode der Wahl!  Das ist ein recht neues und im Vergleich zur „normalen Korrelation“ mathematisch deutlich anspruchsvolleres Konzept, das sich aber generell auf jede „Art“ von Zusammenhang (selbst lineare) anwenden lässt. Eine einfache Berechnung der Distanzkorrelation in SPSS ist bisher nicht möglich, in R hingegen lässt sich die Distanzkorrelation über einen einfachen Befehl berechnen. Vielleicht also ein weiterer Grund, sich näher mit R auseinanderzusetzen… 😉

    Wie R funktioniert erklären wir dir übrigens ebenfalls in unserem Grundlagenkurs.


    Und ganz zum Schluss noch ein kurzer Ausblick: Die Korrelation (Pearson-Korrelation) zwischen zwei Variablen wird uns im Kontext der einfachen linearen Regression wieder begegnen und dort eine zentrale Rolle spielen. Die Regressionsgerade soll ja gerade den linearen Zusammenhang zwischen der abhängigen Variable und dem Prädiktor widerspiegeln und „wie gut“ die Regressionsgerade deine Daten beschreibt ist dann letztendlich von der (absoluten) Größe der Korrelation zwischen abhängiger Variable und Prädiktor abhängig.


    Freu dich also schon, auf das, was kommt und leg bis dahin schon einmal mit der Berechnung deiner Korrelation los!

    Viel Spaß!

    Die Grundlagen statistischer Tests in der Medizin: Eine leicht verständliche Erklärung von p-Wert, Effektstärke und Hypothesen

    Die Grundlagen statistischer Tests in der Medizin: Eine leicht verständliche Erklärung von p-Wert, Effektstärke und Hypothesen

    Die Grundlagen statistischer Tests in der Medizin: Eine leicht verständliche Erklärung von p-Wert, Effektstärke und Hypothesen

    Du hast dich schon immer gefragt, warum wir eigentlich statistische Tests wie ANOVAs, t-Tests oder Regressionen rechnen?

    Wäre es nicht viel einfacher die Ergebnisse deiner Studie anhand der deskriptiven Statistiken oder Grafiken zu beschreiben?

    Welche Bedeutung haben p-Werte und Effektstärken im Rahmen eines statistischen Tests?

    Und wozu brauchen wir Fallzahlschätzungen?

    Alle diese Fragen beantworten wir dir in dieser Artikelreihe.


    Du lernst außerdem:

    • wie inferenzstatistische Tests prinzipiell funktionieren
    • welche Annahmen ihnen zu Grunde liegen und
    • wie du die 3 Ebenen eines jeden statistischen Tests systematisch interpretierst.

    Ein Tipp:

    Lies die einzelnen Kapitel dieses Artikels in der vorgeschlagenen Reihenfolge und springe nicht von Thema zu Thema.

    In den ersten Kapiteln werden wir dir erst einmal ein paar grundlegende statistische Begriffe und die Logik des statistischen Testens erklären.

    Diese Kapitel sind zwar etwas nervig, aber unbedingt notwendig für die korrekte Interpretation deiner Studienergebnisse.

    Unser Studienbeispiel – für dich zum Mitlernen und Verstehen

    Stell dir vor, du möchtest anhand eines statistischen Tests (also inferenzstatistisch) untersuchen, ob Männer in Deutschland im Schnitt häufiger pro Monat zum Arzt gehen als Frauen.

    Zu diesem Zweck erhebst du nun zufällig eine Stichprobe von 50 Männern und 50 Frauen aus Deutschland (wir werden später noch genauer auf die Wahl der Stichprobengröße eingehen).

    Anschließend fragst du jede Person aus deiner Stichprobe, wie oft sie pro Monat den Arzt aufsucht. Direkt danach berechnest du getrennt für Männer und Frauen den zugehörigen Mittelwert, also die durchschnittliche Anzahl der Arztbesuche pro Monat.


    Diese beiden Mittelwerte bezeichnen wir im Folgenden als M1 (Mittelwert der Männer) und M2 (Mittelwert der Frauen).

    Du erhältst die folgenden (natürlich total fiktiven Werte):

    M1 = 3.2

    M2 = 2.5

    Die 50 Männer deiner Stichprobe gehen also durchschnittlich 3.2 Mal pro Monat zum Arzt, die 50 Frauen deiner Stichprobe durchschnittlich 2.5 Mal.


    Oder anders formuliert:

    Der Mittelwertsunterschied zwischen den Männern und Frauen deiner Stichprobe ist M1 – M2 = 0.7.

    Du siehst also ganz klar: Männer haben im Mittel 0.7 Arztbesuche mehr pro Monat als Frauen.


    Bingo, Hypothese bestätigt! 


    Oder nicht?


    Das lernst du im nächsten Artikel.

    Stichprobe oder Population? Wo ist der Unterschied?

    Stichprobe oder Population? Wo ist der Unterschied?

    Stichprobe oder Population? Wo ist der Unterschied?

    Die wichtigste Unterscheidung, die man bei statistischen Tests immer im Hinterkopf haben sollte, ist die zwischen Population und Stichprobe.

     Natürlich möchtest du im eben entwickelten Beispiel nicht wissen, ob die Männer deiner Stichprobe häufiger zum Arzt gehen als die Frauen deiner Stichprobe. Um diese Frage zu beantworten bräuchtest du keinen statistischen Test, sondern du kannst ja unmittelbar sehen, dass M1 größer ist als M2.

    Deine Untersuchungsfrage bezieht sich also nicht auf die erhobene Stichprobe, sondern auf die zugehörige Population, aus der diese Stichprobe stammt.

    Du möchtest wissen, ob Männer in Deutschland häufiger pro Monat einen Arzt aufsuchen als Frauen und gemeint ist damit, dass die Gesamtheit der Männer in Deutschland im Schnitt häufiger einen Arzt aufsucht als die Gesamtheit der Frauen in Deutschland.


    Da du nun aber natürlich nicht die ganze Population (also sämtliche Männer und sämtliche Frauen aus Deutschland) untersuchen kannst, ziehst du eben zufällig aus dieser Population eine Stichprobe.

    Das tust du in der Hoffnung anhand deiner Stichprobe Rückschlüsse auf die Population ziehen zu können (deshalb heißt das Ganze dann auch „Inferenzstatistik“).

    Um diesen extrem wichtigen Unterschied (der auch nicht selten für Verwirrung und Ungereimtheiten in der Interpretation von Untersuchungsergebnissen sorgt) dauerhaft und sichtbar deutlich zu machen, ist es sinnvoll statistische Parameter (wie etwa den Mittelwert, die Standardabweichung oder auch die Korrelation), die sich sowohl auf die Stichprobe als auch auf die Population beziehen können, unterschiedlich zu kennzeichnen.


    So kennzeichnen wir Parameter der Population und der Stichprobe:

    So verwendet man für statistische Parameter, die sich auf die Stichprobe beziehen, lateinische Buchstaben wie beispielsweise M für den Mittelwert, S für die Standardabweichung oder r für die Korrelation zwischen zwei Variablen.

    Meint man hingegen statistische Parameter, die sich auf die gesamte Population beziehen, dann bezeichnet man diese in der Regel mit griechischen Buchstaben wie μ für den Mittelwert der gesamten Population, σ für die Standardabweichung der gesamten Population und ρ für die Korrelation zweier Variablen innerhalb der gesamten Population.


    Du kannst hier gut sehen, wie wichtig und nützlich solche unterschiedlichen Notationen sind, denn wenn man einfach nur von „Mittelwert“ oder „Standardabweichung“ reden würde, dann ist ohne Weiteres natürlich nicht klar, welches der beiden Konzepte (Stichproben- oder Populationsebene) denn nun gemeint ist!

    Anhand unseres einfachen Beispiels siehst du wahrscheinlich sofort, dass:

    1. die beiden Stichprobenmittelwerte M1 und M2 natürlich davon abhängig sind, welche konkrete Stichprobe man gezogen hat (also welche 50 Frauen und welche 50 Männer aus der gesamten Population, denn auch bei Zufallsziehungen kann das ganz schön variieren!)
    2. es ziemlich wahrscheinlich ist, dass man bei einer weiteren zufällig gezogenen Stichprobe von 50 Männern und 50 Frauen ziemlich sicher andere Stichprobenmittelwerte bekommen würde (wie sehr anders weiß man natürlich nicht)
    3. in der Regel die erhobenen Stichprobenmittelwerte M1 und M2 nicht identisch den Mittelwerten der gesamten Population μ1 und μ2 sein werden (also den Mittelwerten von allen Männern bzw. Frauen aus Deutschland). Das folgt aus den ersten beiden Punkten.


    Diese 3 Punkte werden für das weitere Verständnis wichtig sein!

    Sie erklären dir auch, warum wir in verschiedenen Publikationen, die die gleiche Forschungsfrage untersuchen, abweichende Ergebnisse bekommen können.


    Jetzt, wo das geklärt ist, geht es direkt weiter mit den Hypothesen, der Grundlage deines statistischen Tests.

    Lade dir hier die Formelsammlung für deinen Bland-Altman-Plot herunter

    Melde dich für meinen Newsletter an und erhalte sofort das PDF!

    You have Successfully Subscribed!

    10 % Rabatt auf unsereWorkshops & Kurse im Onlineshop!

    Trage dich hier für Dr. Ortmanns beste Maildizin ein und erhalte regelmäßige Rabatte, Tipps und Coachinginhalte für deine empirische Promotion

    You have Successfully Subscribed!

    Lade dir hier die Checkliste für deinen Methodenteil herunter

    Melde dich für meinen Newsletter an und erhalte sofort das PDF!

    You have Successfully Subscribed!


    Jetzt 10 % Rabatt auf alle

    Workshops & Kurse sichern!

    You have Successfully Subscribed!

    Downloade dir hier das Flowchart für deine ANOVA

    Melde dich für meinen Newsletter an und erhalte sofort das PDF!

    You have Successfully Subscribed!

    Lade dir hier die Vorlage für den Aufbau deines Datensatzes herunter

    Melde dich für meinen Newsletter an und erhalte sofort die Excel-Vorlage!

    You have Successfully Subscribed!