Null- und Alternativhypothese – die Grundlage deiner Studie

Null- und Alternativhypothese – die Grundlage deiner Studie

Null- und Alternativhypothese – die Grundlage deiner Studie

Bei allen statistischen Tests gibt es immer eine Nullhypothese (kurz: H0) und eine Alternativhypothese (kurz: H1).


Ganz wichtig zu wissen:

Null- und Alternativhypothese beziehen sich immer auf die Populationsebene und nicht auf die Stichprobenebene.

Wie schon im ersten Artikel gesagt bräuchte man ja überhaupt keinen Test, wenn sich die Hypothesen auf die Stichprobenebene beziehen würden (was wäre das Leben dann einfach).


Die H0 und die H1 machen jeweils eine Aussage über statistische Parameter der Populationsebene, wobei sich diese Aussagen gegenseitig ausschließen.

Die Aussagen der H0 und der H1 können also nicht gleichzeitig wahr sein!

In unserem Beispiel lautet die H0, dass Männer und Frauen im Schnitt gleich häufig pro Monat den Arzt aufsuchen (und gemeint ist natürlich die Populationsebene).


Die H1 hingegen besagt, dass Männer häufiger pro Monat den Arzt aufsuchen (und gemeint ist hier natürlich ebenfalls die Populationsebene).


Du siehst, beide Hypothesen können nicht zusammen wahr sein!


Man könnte die beiden Hypothesen für unser Beispiel kurz auch folgendermaßen hinschreiben:


H0: μ1 = μ2

H1: μ1 > μ2

Die Alternativhypothese H1 kann dabei allgemein gerichtet oder ungerichtet sein. In unserem Beispiel ist sie gerichtet, da quasi die „Richtung“ des Unterschieds zwischen Männern und Frauen angegeben wird (μ1 > μ2).


Eine ungerichtete Alternativhypothese würde in unserem Beispiel besagen, dass sich Männer und Frauen im Schnitt darin unterscheiden, wie häufig sie pro Monat den Arzt aufsuchen, aber nicht, wie genau der Unterschied aussieht.


Wäre das die Alternativhypothese für unser Beispiel, dann könnte man diese kurz auch so schreiben:

H1: μ1 ≠ μ2

Aber müssen wir nur Hypothesen formulieren und dann geht es direkt los mit dem Testen?


Leider nein, das wäre ja zu schön. Dafür brauchen wir noch etwas mehr.
 

Weiter geht es daher mit dem Fehler 1. und 2. Art.

Fehler 1. und 2. Art und die Sache mit der Wahrscheinlichkeit

Fehler 1. und 2. Art und die Sache mit der Wahrscheinlichkeit

Fehler 1. und 2. Art und die Sache mit der Wahrscheinlichkeit

Es gibt ein paar Dinge, die du dir am besten irgendwo hin tätowierst, damit du sie nicht vergisst:


Ganz wichtig zu verstehen ist, dass du mit statistischen Tests nie (NIE!) beweisen kannst, ob denn nun deine H0 oder deine H1 ohne jeglichen Zweifel richtig ist.


Werbeversprechen wie: „Klinische Studien beweisen, dass unser Make-Up Akne reduziert“ sind falsch und ärgern mich so sehr, dass ich das Produkt garantiert nicht kaufe.


Ein statistischer Test erlaubt es dir stattdessen, dich aufgrund von Wahrscheinlichkeitsüberlegungen (mehr dazu gleich) für oder gegen die H1 zu entscheiden.

Nicht mehr und nicht weniger.

Eine erlaubte Aussage wäre daher folgende: „Klinische Studien sprechen dafür, dass unser Make-Up Akne reduziert.“

Um das besser zu verstehen, zeigen wir dir im Folgenden, welche (Fehl)-Entscheidungen im Rahmen eines statistischen Tests möglich sind.


Insgesamt gibt es 4 mögliche Szenarien, die bei einem statistischen Test eintreten können:


  1. Wenn die H0 richtig ist, kannst du dich (korrekterweise) auch für die H0 entscheiden.
  2. Wenn die H0 richtig ist, kannst du dich aber auch (fälschlicherweise) für die H1 entscheiden. Diese Fehlentscheidung nennt man den Fehler 1. Art.
  3. Wenn hingegen die H1 richtig ist, kannst du dich (korrekterweise) auch für die H1 entscheiden.
  4. Wenn die H1 richtig ist, kannst du dich wiederum aber auch (fälschlicherweise) für die H0 entscheiden. Diese Fehlentscheidung nennt man den Fehler 2. Art.

Hier das Ganze mal als Übersicht:

Wahr ist
 

Entscheidung

für

H0 H1
H0 Korrekt Fehler 2. Art
H1 Fehler 1. Art Korrekt

Hier das Ganze mal als Übersicht:

Wahr ist


Entscheidung

für

H0 H1
H0 Korrekt Fehler 2. Art
H1 Fehler 1. Art Korrekt

Das Problem ist also, dass du niemals wissen kannst, ob nun die H0 oder die H1 wahr ist, und daher kann deine Entscheidung eben auch falsch sein.


In unserem Beispiel würdest du also den Fehler 1. Art begehen, wenn du dich anhand des Tests dafür entscheidest, dass Männer im Schnitt häufiger zum Arzt gehen als Frauen (Entscheidung für H1), obwohl sich Männer und Frauen darin eigentlich nicht unterscheiden (die H0 gilt).


Den Fehler 2. Art würdest du begehen, wenn du dich dafür entscheiden würdest, dass sich Männer und Frauen nicht darin unterscheiden, wie oft sie im Schnitt zum Arzt gehen (Entscheidung für H0), obwohl die Männer eigentlich häufiger im Schnitt den Arzt aufsuchen (die H1 gilt).

Das Interessante daran ist:

Mit jeder der vier Entscheidungsmöglichkeiten ist eine bestimmte Wahrscheinlichkeit verknüpft.

 Und da diese Wahrscheinlichkeiten für die Logik statistischer Tests enorm wichtig sind, bekommen auch sie wieder eine eigene Bezeichnung: 

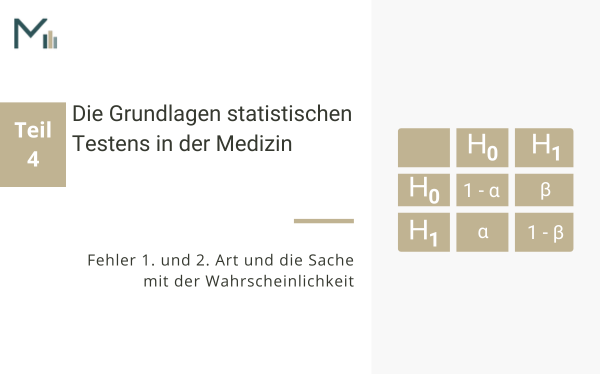
  • die Wahrscheinlichkeit, den Fehler 1. Art zu begehen bezeichnet man mit α
  • die Wahrscheinlichkeit, den Fehler 2. Art zu begehen, mit β.
Wahr ist
 

Entscheidung

für

H0 H1
H0 1 – α β
H1 α 1 – β
Wahr ist


Entscheidung

für

H0 H1
H0 1 – α β
H1 α 1 – β

Bitte nicht verwechseln: In der oberen Tabelle geht es um Entscheidungen, in der unteren Tabelle um die zugehörigen Wahrscheinlichkeiten!


Wie du im nächsten Kapitel sehen wirst, können wir das α festlegen, und somit die Wahrscheinlichkeit für den Fehler 1. Art kontrollieren. Für das β ist die Lage leider etwas komplizierter. Im letzten Kapitel werden wir dir aber eine Möglichkeit vorstellen, die Wahrscheinlichkeit für den Fehler 2. Art zumindest in Teilen zu kontrollieren.


Wichtig ist außerdem, dass α und β nicht unabhängig voneinander sind:


Je kleiner in einer konkreten Testsituation dein α ist, umso größer wird dein β sein. Und je größer dein α ist, umso kleiner wird dein β sein.

Das ist in gewisser Weise ein Dilemma, von dem du schon mal gehört haben solltest. Wir werden später auf diesen Punkt zurückkommen.

Fazit:


In diesem Kapitel hast du gelernt, dass es im Rahmen des statistischen Testens um eine Entscheidung für oder gegen die Nullhypothese/die Alternativhypothese geht.

Diese Entscheidung kann falsch oder richtig sein, da wir die Wahrheit nicht kennen. Es ist daher nicht möglich, mit einem Test Hypothesen zu beweisen und definitive Aussagen zu tätigen.


Wie du dir natürlich auch denken kann, ist unsere Entscheidung nicht vollkommen willkürlich. Stattdessen entscheiden wir uns aus guten Gründen für die Null- oder Alternativhypothese (dazu mehr in den folgenden Kapiteln).


Behalte dies im Rahmen deiner Auswertung immer im Hinterkopf – dann wird dir auch die Diskussion deiner Ergebnisse im Licht der Literatur viel leichter fallen.


Nun, wo du die 4 möglichen Szenarien sowie die damit verbunden Fehlerarten und Wahrscheinlichkeiten kennst, geht es direkt weiter zur Testlogik.

Die Testlogik und der p-Wert

Die Testlogik und der p-Wert

Die Testlogik und der p-Wert

Was passiert nun genau bei einem statistischen Test und wie soll einem das Ergebnis helfen, eine Entscheidung zwischen H0 und H1 zu treffen?


Vereinfacht gesagt gibt dir das Ergebnis eines statistischen Tests an, wie wahrscheinlich es ist, dass man die Daten, die man erhoben hat, bekommt, wenn die H0 richtig wäre.


Hier noch mal einfacher ausgedrückt:

Man tut also so, als ob die H0 richtig wäre und schaut sich dann an, wie wahrscheinlich es ist, dass man die Daten, die man erhoben hat unter dieser Bedingung bekommen würde.


Und jetzt nochmal ganz konkret:

In unserem Beispiel würden wir also als Testergebnis die Wahrscheinlichkeit dafür bekommen, dass die Differenz zwischen dem Mittelwert einer zufällig gezogenen Stichprobe von 50 Männern und dem Mittelwert einer zufällig gezogenen Stichprobe von 50 Frauen genau M1 – M2 = 3.2 – 2.5 = 0.7 ist, wenn sich Frauen und Männer auf Populationsebene eigentlich nicht darin unterscheiden, wie oft sie im Schnitt pro Monat den Arzt aufsuchen (also wenn die H0 richtig wäre).


Der letzte Satz ist eine harte Nuss, lies ihn am besten nochmal, um ganz sicher zu gehen, dass du ihn verstanden hast.


Erinnern wir uns noch mal kurz an die 3 Punkte aus Kapitel 2:


Hier hast du gelernt, dass es je nach gezogener Stichprobe zu sehr unterschiedlichen Mittelwerten kommen kann und dass diese Mittelwerte sich deutlich von den Mittelwerten auf Populationsebene (die wir ja nicht kennen) unterscheiden können.

Es ist somit nicht ausgeschlossen, dass man eine Stichprobenmittelwertsdifferenz von M1 – M2 = 0.7 bekommt, obwohl sich auf Populationsebene Männer und Frauen nicht unterscheiden (also die H0 gilt).


So können wir etwa ungünstigerweise ein paar Männer in unserer Stichprobe haben, die häufiger zum Arzt gehen als die restlichen Männer der Population (oder ein paar Frauen, die seltener zum Arzt gehen als die restlichen Frauen der Population).


Allerdings wird das natürlich umso unwahrscheinlicher, je größer die erhobene Stichprobenmittelwertsdifferenz tatsächlich ist.


Wenn die H0 richtig wäre, sich Männer und Frauen (wiederum: die Population!) also nicht unterscheiden, ist es natürlich unwahrscheinlicher, dass man eine Mittelwertsdifferenz von 15 bekommt, als eine Differenz von 1, 0.7 oder 0.1 usw. Aber ausgeschlossen ist es eben nicht.


Woran erkennen wir nun also, woran wir sind? 

Dafür nutzen wir den p-Wert!

Der p-Wert und die Entscheidung


Der Clou ist nun, dass sich für jede mögliche Stichprobenmittelwertsdifferenz in unserem Beispiel berechnen lässt, wie wahrscheinlich es ist, dass diese auftritt, wenn die H0 richtig wäre.

Diese Wahrscheinlichkeit ist nichts anderes als der „berühmt-berüchtigte“ p-Wert, von dem du sicher schon gehört hast. Und genau dieser p-Wert dient uns letztendlich als Kriterium dafür, ob wir uns für die H0 oder für die H1 entscheiden sollten.


Es gilt: Je geringer der p-Wert ist, umso „unplausibler“ ist die H0.


Wenn wir in unserem Beispiel etwa eine Stichprobenmittelwertsdifferenz von 15 erhoben hätten und wir als Ergebnis unseres Tests einen p-Wert von 0.001 bekommen hätten, dann würde es ziemlich schwer werden, uns selbst oder andere davon zu überzeugen, dass die H0 richtig ist.


Denn in diesem Fall läge die Wahrscheinlichkeit, dass man diese Differenz bekommt, wenn die H0 richtig wäre, ja nur bei 0.1%, und wäre somit wirklich sehr klein. Somit sollten wir uns besser für die H1 entscheiden!


Wir wissen somit natürlich auch (und hier kommt das Vier-Felder-Schema aus Kapitel 4 wieder ins Spiel), dass wenn wir uns in diesem Fall für die H1 entscheiden, die Wahrscheinlichkeit, dass wir uns fälschlicherweise für die H1 entscheiden (also den Fehler 1. Art begehen) natürlich ebenfalls 0.1% beträgt.


Der p-Wert ist ja gerade die Wahrscheinlichkeit, dass wir die Mittelwertsdifferenz bekommen, die wir tatsächlich erhoben haben, wenn die H0 richtig wäre.


Es stellt sich also nur noch die Frage, wo genau wir die Grenze für unsere Entscheidung für oder gegen die H0 setzen sollten.


Einerseits sollte der p-Wert, ab dem wir uns für die H1 entscheiden, natürlich nicht „zu groß“ sein, weil dann ja auch die Wahrscheinlichkeit, sich fälschlicherweise für die H1 zu entscheiden (den Fehler 1. Art zu begehen) „zu groß“ wäre.


Andererseits sollte der p-Wert, ab dem wir uns für die H1 entscheiden, natürlich auch nicht „zu klein“ sein. Dann würden wir zwar die Wahrscheinlichkeit für einen Fehler 1. Art ebenfalls sehr gering halten, allerdings würden wir uns dann auch nur in „sehr eindeutigen“ Fällen gegen die H0 entscheiden. Man spricht in diesem Fall auch von „konservativem Testen“.


Gerade in der Medizin sind die Effekte oder Unterschiede, die man mit seiner Untersuchung aufdecken möchte, aber oftmals klein bis mittelgroß (auch moderat genannt) und diese Effekte würden einem dann „durch die Lappen“ gehen, da man sich eben „zu konservativ“ verhält, also einfach zu streng testet.


Zudem können gerade in der Medizin die beiden Fehlentscheidungen (Fehler 1. Art und Fehler 2. Art) mit unterschiedlich schwerwiegenden praktischen Konsequenzen einhergehen:


Testest du beispielsweise, ob ein neu entwickeltes Medikament wirksamer ist als das herkömmlich eingesetzte und du weißt außerdem, dass das neue Medikament mit deutlich schwereren Nebenwirkungen einhergeht, dann ist der Fehler 1. Art (du entscheidest dich dafür, dass das neue Medikament wirksamer ist, obwohl dem nicht so ist) natürlich schwerwiegender als der Fehler 2. Art (du entscheidest dich dafür, dass beide gleich wirksam sind, obwohl das neue Medikament wirksamer ist).


Hier kommt somit ein weiterer wichtiger Punkt ins Spiel, nämlich die Eigenverantwortung der Forscherin bzw. des Forschers (die Statistikprogramme können einem ja nicht alle Entscheidungen abnehmen).


Du solltest also vor deiner Untersuchung festlegen, wie groß die Wahrscheinlichkeit für den Fehler 1. Art bei deinem Test denn maximal sein soll:

Diese Grenze bezeichnet man auch als α oder α-Niveau (siehe wieder das Vier-Felder-Schema in Artikel 4). In der Regel wird das α-Niveau per Konvention auf α = .05 festgesetzt, es kann aber auch Fälle geben, in denen man mit guten Gründen ein anderes α-Niveau wählen sollte (wie etwa in dem obigen Beispiel mit den neuen Medikament, das mehr Nebenwirkungen hat, als die Standardtherapie).


Wenn das α von dir festgelegt wurde, dann ist aufgrund der eben erläuterten Testlogik damit auch deine „Entscheidungsstrategie“ festgelegt:


  • Ist der p-Wert aus deinem Test kleiner (oder gleich) dem vorher festgelegten α, dann solltest du dich gegen die H0 entscheiden.
  • Ist der p-Wert aus deinem Test größer als das vorher festgelegte α, dann solltest du dich für die H0 entscheiden.

Hast du dein α-Niveau auf .05 gesetzt, dann weißt du, dass du dich mit dieser Entscheidungsstrategie unter der Annahme, dass die die H0 richtig ist in 95% aller Fälle auch richtigerweise für die H0 entscheidest und nur in 5% aller Fälle den Fehler 1. Art begehst.


Ist p ≤ α, dann spricht man auch von einem „signifikanten Ergebnis auf dem Niveau α“ (das hast du bestimmt auch schon einmal gehört) oder kurz von einem „signifikanten Ergebnis“.


Wichtiger Hinweis: Wenn du (was in der Medizin häufig passiert) mehrere Tests auf dem gleichen Datensatz durchführst, dann kommt es zu einem ungünstigen Effekt, der sogenannten α-Inflation. Was genau das ist und was du dagegen tun kannst erfährst du in unserem Glossar unter „multiplem Testen“ und „α-Inflation“.

Wie interpretierst du nun deine Testergebnisse?


Wie schon gesagt, egal wie das Ergebnis ausfällt (Entscheidung für oder gegen die H0), ein statistischer Test kann nicht „beweisen“, ob nun die H0 oder die H1 richtig ist.


Du entscheidest dich anhand deines Testergebnisses (also mit guten Gründen!) dafür, anzunehmen, dass entweder die H0 oder die H1 richtig ist.

Aber du weißt natürlich auch (siehe wieder das Vier-Felder-Schema in Artikel 4), dass du mit deiner Entscheidung möglicherweise falsch liegen kannst, da du ja den Fehler 1. oder 2. Art begehen kannst.


Und wie schon erklärt, weißt du bei einem signifikanten Ergebnis ebenfalls, dass die Wahrscheinlichkeit, dass du dich fälschlicherweise für die H1 entscheidest (Fehler 1. Art) nicht größer ist als das vorher von dir festgelegte α, also in der Regel 5%.


Aber Vorsicht!

Bei einem nicht-signifikanten Ergebnis ist die Lage etwas komplizierter!

Wenn du dich für die H0 entscheidest, weißt du zwar, dass die Wahrscheinlichkeit dafür, dass du deine erhobenen Daten bekommen hättest, wenn die H0 richtig wäre, größer ist als das vorher festgelegte α (das ist die oben erklärte Logik des Tests und der Grund, warum du dich für die H0 entscheidest).


Allerdings kannst du hier nicht ohne Weiteres bestimmen, wie hoch die Wahrscheinlichkeit dafür ist, dass du dich fälschlicherweise für die H0 entscheidest (also den Fehler 2. Art begehst).


Das ist blöd, denn wenn diese Wahrscheinlichkeit β recht hoch wäre, sagen wir beispielsweise 50%, dann wärst du in einer recht ungünstigen Position.

Denn das würde einerseits bedeuten, dass du dich aufgrund der Testlogik für die H0 entscheiden müsstest, da ja p > α.

Andererseits wüsstest du aber, dass du dich bei dieser Entscheidung für die H0 mit einer Wahrscheinlichkeit von 50% irren würdest.


Doch, wie das immer so ist, gibt es glücklicherweise eine Möglichkeit, Tests so zu konstruieren, dass du auch die Wahrscheinlichkeit β in gewisser Weise kontrollieren kannst.


Um diese Möglichkeit nachvollziehbar erklären zu können, müssen wir uns aber vorher noch mit einigen weiteren Feinheiten statistischer Tests beschäftigen (keine Sorge, bald hast du es geschafft).

Das Problem der Stichprobengröße

Das Problem der Stichprobengröße

Das Problem der Stichprobengröße


Nun liegt der Teufel ja häufig im Detail, und in der Inferenzstatistik ist das leider auch so.

Eine der unschönen Eigenschaften statistischer Tests (auf die man auch beim Lesen von Forschungsberichten immer achten sollte) ist, dass der p-Wert wesentlich von der Stichprobengröße abhängt.


Warum das so ist, würde leider etwas mehr mathematisches Hintergrundwissen erfordern.

Als Faustregel kannst du dir jedoch merken, dass, bei ansonsten gleichen Bedingungen, der p-Wert umso geringer ausfallen wird, je größer die Stichprobe ist.


Nehmen wir einmal an, dass wir für unser Beispiel oben (Stichprobe von 50 Männern und 50 Frauen, Mittelwertsdifferenz von M1 – M2 = 0.7) einen p-Wert von p = 0.12 bekommen würden und uns somit für die H0 entscheiden sollten.


Wenn man nun statt jeweils 50 Männern und Frauen jeweils 50.000 Männer und Frauen erhoben hätte und die gleiche Mittelwertsdifferenz von 0.7 bekommen würde, dann wäre der p-Wert deutlich niedriger (definitiv kleiner als unser α = .05) und wir sollten uns dann gegen die H0 entscheiden.


Warum soll das eine unschöne Eigenschaft sein?


Man könnte ja denken: „OK, dann brauche ich doch einfach immer nur ziemlich große Stichproben zu erheben und dann werde ich wohl auch ein signifikantes Ergebnis bekommen!“


Das ist so weit richtig, aber die falsche Herangehensweise!


Das Problem ist, dass man stets zwischen statistischer Bedeutsamkeit und inhaltlicher, also klinischer Bedeutsamkeit eines Ergebnisses unterscheiden sollte.


Wenn man jetzt (wieder in unserem Beispiel) für 50.000 Männer und 50.000 Frauen eine Mittelwertsdifferenz von M1 – M2 = 0.000001 mit einem zugehörigen p-Wert von p = .015 bekommen würde, dann wäre das Ergebnis zwar statistisch signifikant, da p ≤ .05.


Allerdings würde man hier sofort (ohne jegliche statistischen Kenntnisse haben zu müssen) sagen, dass dieser gefundene Unterschied inhaltlich und somit klinisch ziemlich irrelevant ist.


Denn diese Differenz besagt ja nichts anderes, als dass der gefundene Unterschied darin besteht, dass die Männer im Schnitt alle 1.000.000 Monate (oder grob alle 83.333 Jahre) einmal häufiger den Arzt aufsuchen als die Frauen. Wow.


Anders formuliert heißt das:


Wann immer es um die Beurteilung und Interpretation von Untersuchungsergebnissen geht (die eigenen oder die anderen Personen), dann sollte man nicht allein sklavisch auf die p-Werte achten, sondern immer auch inhaltliche und klinische Überlegungen miteinbeziehen.


Aus diesem Grund bestehen mittlerweile auch die meisten seriösen Journals darauf, bei Publikationen eben nicht nur die p-Werte zu berichten, sondern auch andere Größen wie etwa die Effektgröße (z.B Cohen’s d oder der Determinationskoeffizient) oder Konfidenzintervalle, die nicht (oder zumindest weniger stark) von der Stichprobengröße abhängig sind.


Jetzt hast du endlich die theoretische Seite des statistischen Testens hinter (und hoffentlich eine Menge gelernt!).


Im nächsten Artikel geht es nun endlich um die konkrete Beurteilung deiner Studienergebnisse – es wird also ganz praktisch!

So beurteilst du deine Studienergebnisse

So beurteilst du deine Studienergebnisse

So beurteilst du deine Studienergebnisse

Wenn du die Ergebnisse deiner Studie beurteilst, dann schau dir unbedingt die folgenden drei Ebenen eines jeden Effekts an:


1. (Statistische) Signifikanz

Dieser Punkt ist am leichtesten. Hier geht es nur darum, ob dein Testergebnis statistisch signifikant ist oder eben nicht, also ob p ≤ a.


2. Effektstärke

Da du weißt, dass die statistische Signifikanz von der Stichprobengröße abhängig ist, solltest du im nächsten Schritt Effektstärkemaße berechnen, um dein Ergebnis besser beurteilen zu können.

Hier kommt es nun darauf an, was für einen Test du genau durchgeführt hast, da es unterschiedliche Effektstärkemaße für unterschiedliche Verfahren gibt (und in der Regel auch mehrere Effektstärkemaße für ein Verfahren).


Für die gängigsten Verfahren sind das beispielsweise:

  • Cohens d oder Hedges g für den t-Test
  • der Determinationskoeffizient R² (oder das adjustierte R²) für die lineare Regression
  • η²(oder das partielle η²) oder ω² für varianzanalytische Modelle

Für jedes Effektstärkemaß gib es Konventionen (!), wie deren Größe zu interpretieren ist („kleiner“, „mittlerer“ oder „großer Effekt“), die immer im statistischen Analyseteil deiner Dissertation definiert werden sollten.


Effektstärken werden weniger stark von der Stichprobengröße beeinflusst als der p-Wert und geben dir somit einen besseren Eindruck über die statistische Bedeutsamkeit deines Effekts.

Sie sollten daher zusätzlich zum p-Wert berichtet und interpretiert werden.

(Wir können hier leider nicht im Detail auf die verschiedenen Effektstärken eingehen, weil es den Inhalt dieses Artikels sprengen würden. In jedem unserer Onlinekurse berechnen wir die Effektstärken aber serienmäßig mit und erklären dir genau, wie du sie interpretieren kannst).


3. Klinische Bedeutsamkeit

Hier bist du als Mediziner und klinischer Forscher gefragt! 

Nutze für diesen letzten Schritt dein gesamtes klinisches Wissen um die inhaltliche Bedeutsamkeit deines Effekts zu beurteilen.

Konzentriere dich dabei auf die deskriptive Statistik deines Effekts: 

  • Überlege zuerst in welcher Einheit deine untersuchten Variablen gemessen wurden. das hilft dir bei der klinischen Interpretation der Mittelwerte.
  • Schaue dir dann die Mittelwerte der Gruppen unabhängig von der Mittelwertsdifferenz an – sind sie im Normbereich, erhöht oder erniedrigt? Diese Einordnung hat nicht selten einen Einfluss auf die Bedeutung der Mittelwertsdifferenz (gleiches gilt für jeden anderen Test und alle von dir erstellten deskriptiven Statistiken)
  • Überlege dann: Ist z.B. die gemessene Mittelwertsdifferenz klinisch relevant, oder stellt sie keinen wichtigen Unterschied dar? (Das passiert z.B. sehr oft bei sehr großen Stichproben, die schnell zu signifikanten Testergebnissen führen.)
  • Achte nicht nur auf relative (%), sondern auch auf absolute (n) Unterschiede (sofern untersucht).
    Eine Reduktion der Nebenwirkung „Erbrechen“ um 50% durch das neue Studienmedikament im Vergleich zur Standardtherapie kann auf den ersten Blick sehr viel erscheinen und auch signifikant sein.
    Wenn aber vorher nur 2 von 10.000 Patienten unter Einnahme des Standardmedikaments erbrochen haben, und unter dem Studienmedikament nur noch ein Patient erbricht, dann stellt sich die Frage, ob wir wirklich von einer klinischen Überlegenheit des neuen Medikaments sprechen können und ob z.B. der höhere Preis des neuen Medikaments wirklich gerechtfertigt ist….

Somit ist es als Mediziner deine Aufgabe, deine Studienergebnisse anhand aller 3 Ebenen – Signifikanz, Effektstärke UND klinische Relevanz umfassend zu beurteilen.


In dem letzten Artikel dieser Reihe lernst du nun noch, wie du mithilfe der Fallzahlschätzung die richtige Stichprobengröße für deine Untersuchung ermittelst.

Lade dir hier die Formelsammlung für deinen Bland-Altman-Plot herunter

Melde dich für meinen Newsletter an und erhalte sofort das PDF!

You have Successfully Subscribed!

10 % Rabatt auf unsereWorkshops & Kurse im Onlineshop!

Trage dich hier für Dr. Ortmanns beste Maildizin ein und erhalte regelmäßige Rabatte, Tipps und Coachinginhalte für deine empirische Promotion

You have Successfully Subscribed!

Lade dir hier die Checkliste für deinen Methodenteil herunter

Melde dich für meinen Newsletter an und erhalte sofort das PDF!

You have Successfully Subscribed!


Jetzt 10 % Rabatt auf alle

Workshops & Kurse sichern!

You have Successfully Subscribed!

Downloade dir hier das Flowchart für deine ANOVA

Melde dich für meinen Newsletter an und erhalte sofort das PDF!

You have Successfully Subscribed!

Lade dir hier die Vorlage für den Aufbau deines Datensatzes herunter

Melde dich für meinen Newsletter an und erhalte sofort die Excel-Vorlage!

You have Successfully Subscribed!